LLM-Inferenz messgestützt gestalten
Modellgröße, Quantisierung, Routing und Serving-Hardware anhand von Qualitäts-, Latenz-, Kosten- und Energiezielen bewerten
Ihr Sprachmodell liefert brauchbare Antworten, doch unter Last steigen Wartezeiten und Ressourcenbedarf. Ein kleineres Modell oder komprimierte Gewichte können Vorteile bringen – aber wie prüfen Sie, ob die Qualität genügt und die Änderung im Gesamtsystem tatsächlich hilft? Dieses Buch führt Sie von überprüfbaren Zielbudgets über kontrollierte Vergleiche zu einer nachvollziehbaren Architektur- und Betriebsentscheidung.
Kauf und Download im Kundenbereich my.agentbooks.de
inkl. MwSt.
Das Buch in 6 Min.
Basierend auf diesem AgentBook wurde der folgende Podcast direkt mit NotebookLM von Google erstellt — eine gesprochene Übersicht über Aufbau, Kernaussagen und Grenzen des Werks, für unterwegs, vor dem Kauf oder als Wiederholung.
10 Kapitel, an der Umsetzung entlang
Was du mit diesem AgentBook machen kannst
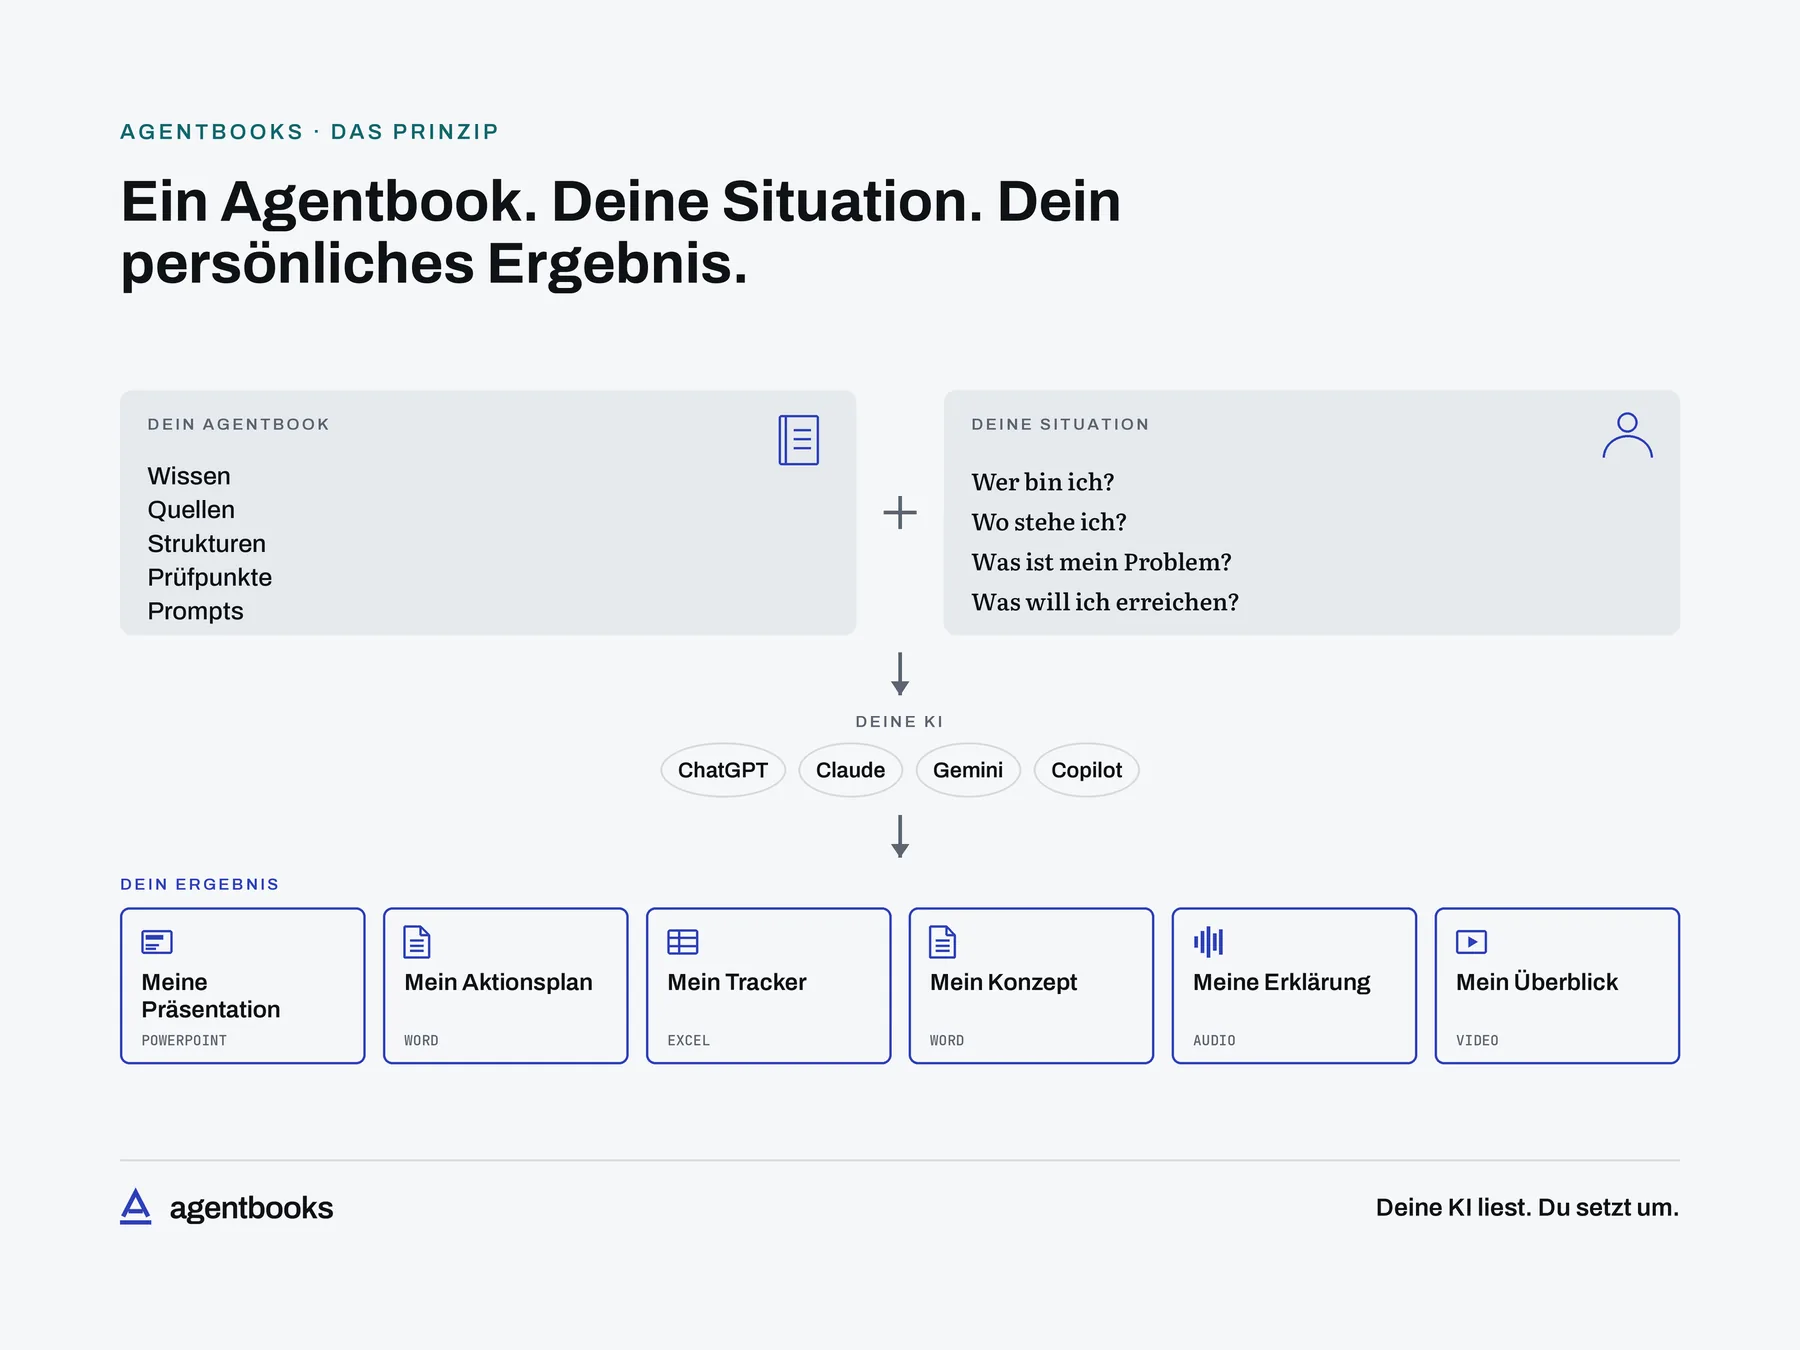
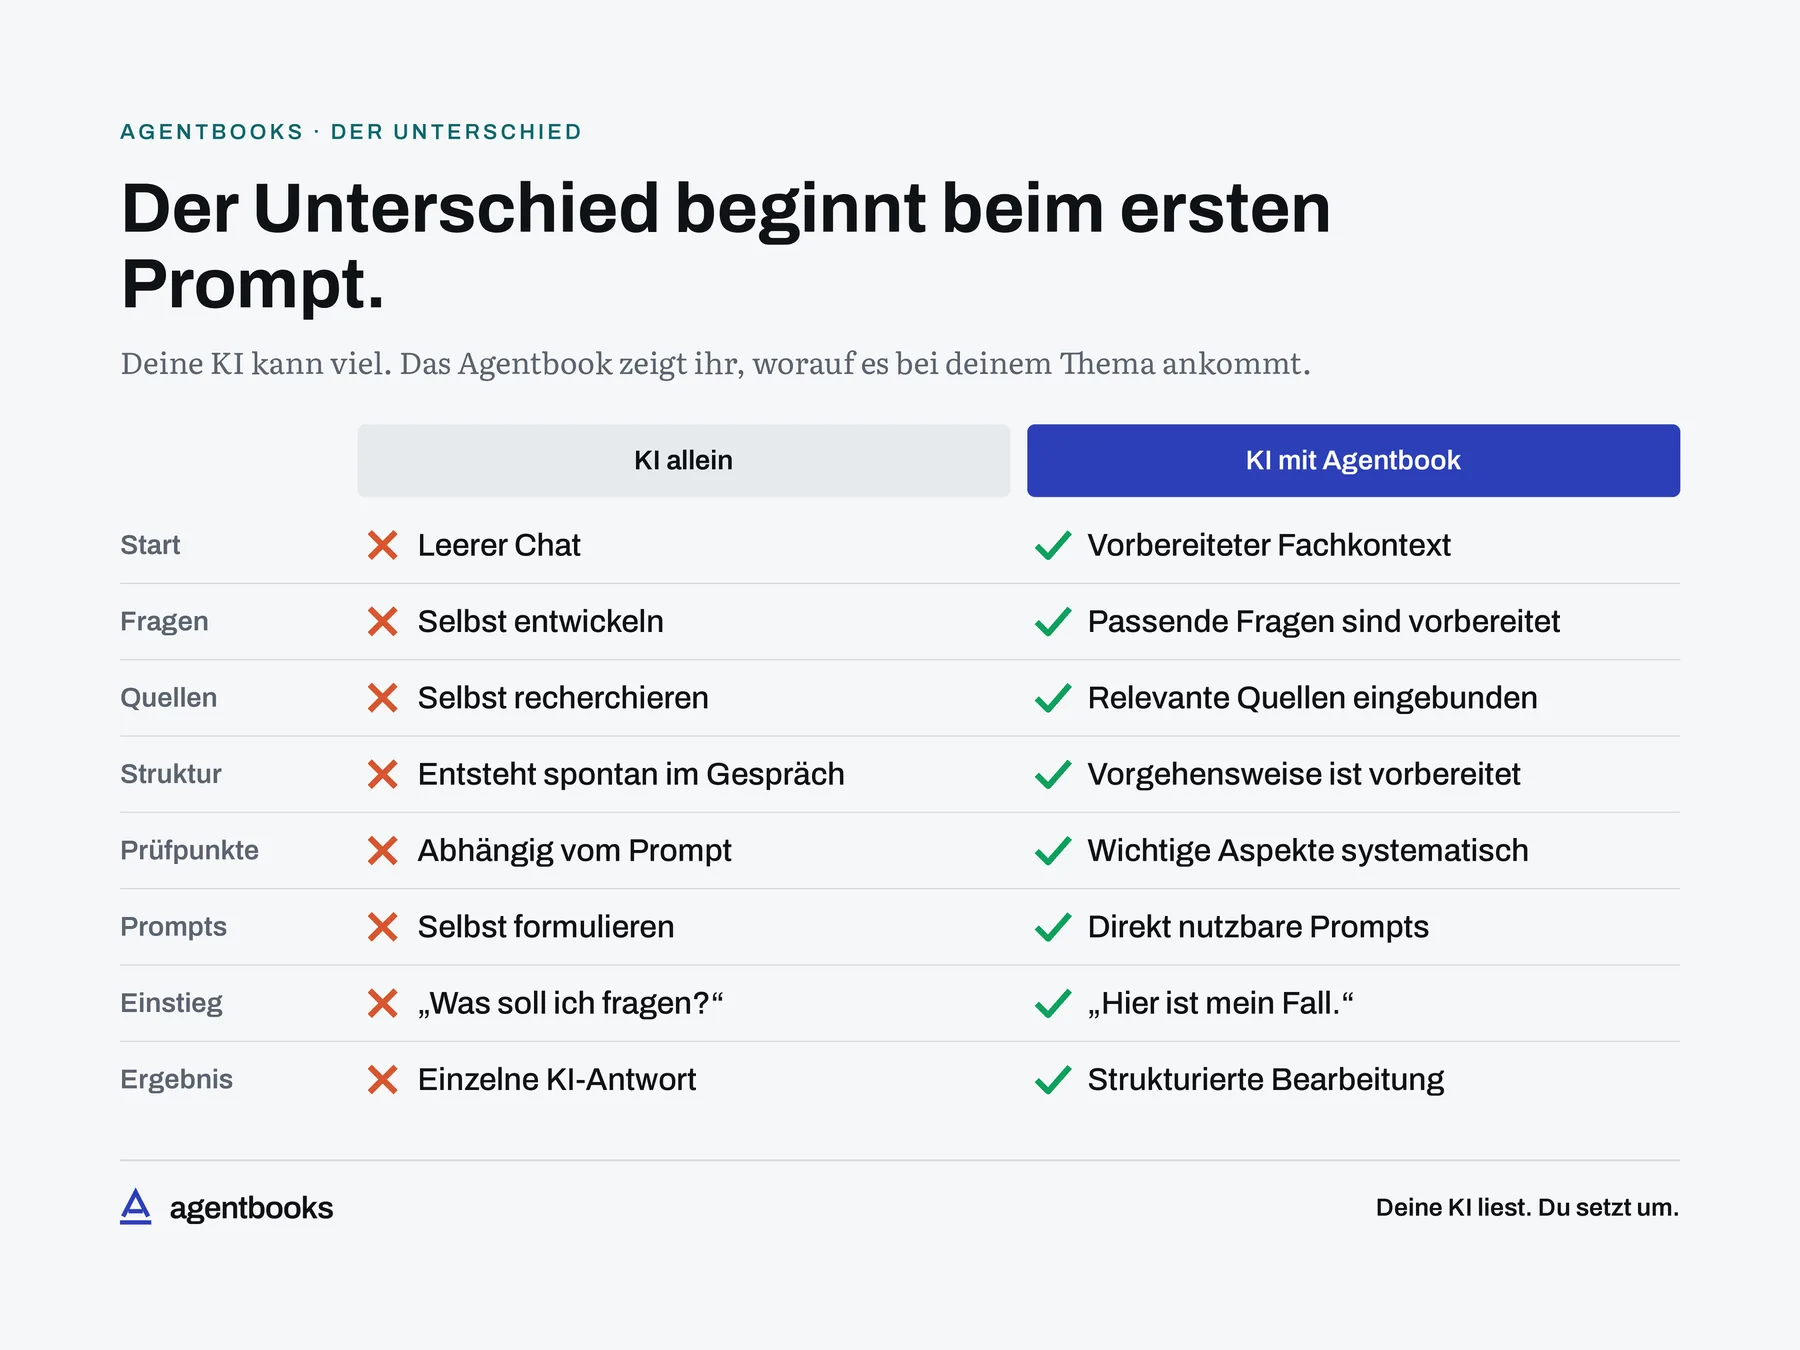
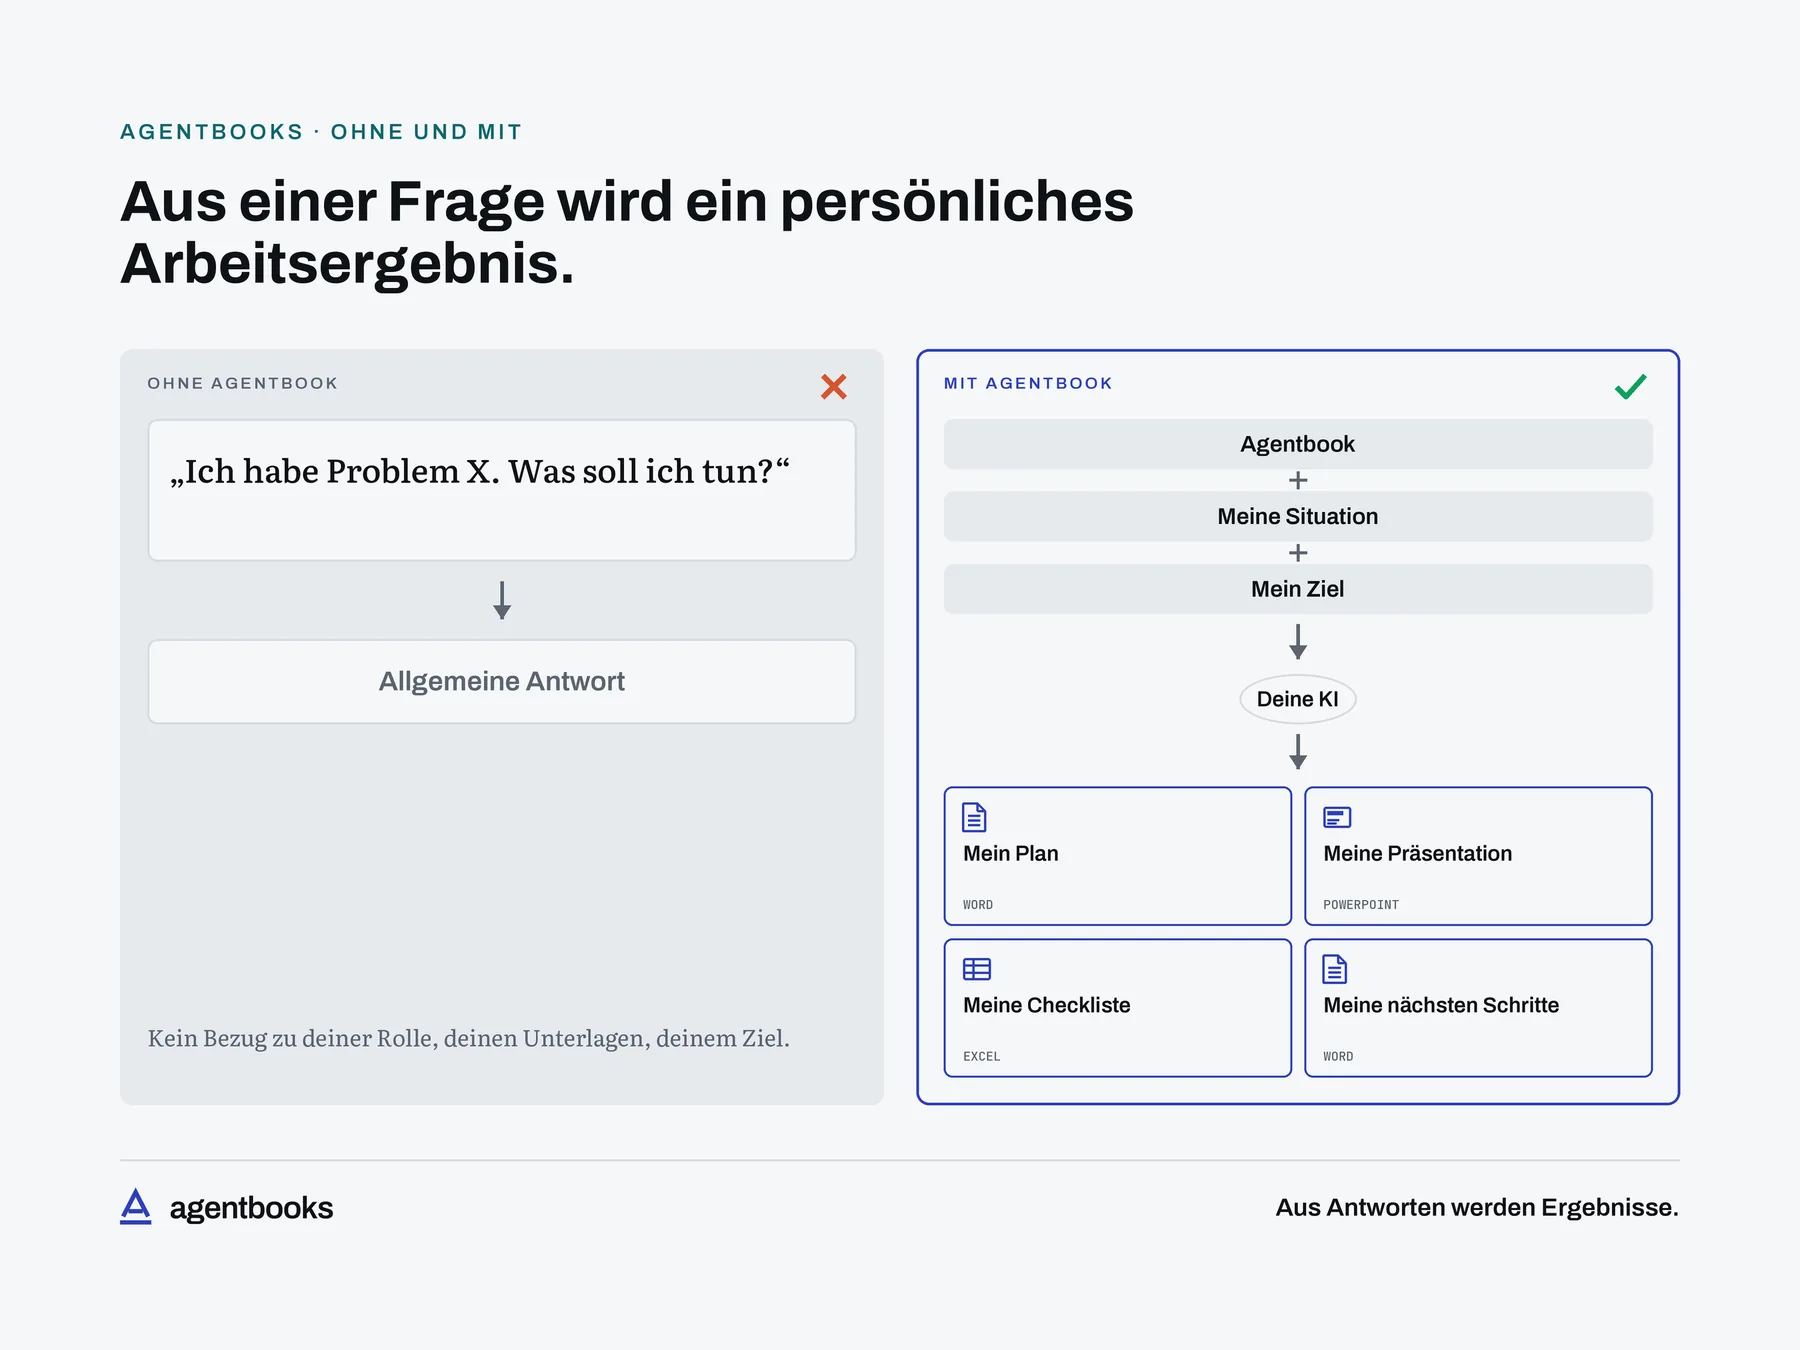
Ein AgentBook ist kein E-Book. Du gibst deiner KI das geprüfte Wissen, die Prüfpunkte und die Arbeitsanweisungen dieses Buchs — und arbeitest damit an deiner eigenen Aufgabe.
Inferenzberater lernt gerade dieses Buch.
Der Inferenzberater unterstützt Sie ausschließlich mit dem Wissen dieses Buches bei Architekturvergleichen, Versuchsplanung und nachvollziehbaren Entscheidungen für textbasierte LLM-Inferenz.
- 01Trainiert auf dem BuchinhaltEr antwortet aus diesem Werk, nennt den Abschnitt und benennt die Grenze.
- 02Skills für konkrete AufgabenAus dem Inhalt werden derzeit Fähigkeiten für typische Anwendungen abgeleitet.
- 03Deine KI bleibt deine KIDer Agent kommt als Paket in das Konto, das du ohnehin nutzt.
Kein Rechtsrat, keine Zusage zum Termin · Datenschutz
Was im Werk enthalten ist
Das Buch (PDF)
157 Seiten · 14,0 MB
Manuskript (Markdown)
421 KB
KI-Ausgabe
3,5 MB
Prüfstand dieses Werks
Fassungsgeschichte
Ein Arbeitsmittel auf Basis eines geprüften Werks — kein Rechtsrat und keine Prüfung deines Einzelfalls.
Für wen dieses AgentBook gemacht ist
Dieselbe Wissensbasis, mehrere Einsatzlogiken. Das Werk unterscheidet sich nicht.
LLM-Entwicklungsteams
Sie erhalten einen strukturierten Prüfprozess, um Modellqualität, Quantisierung und Serving-Leistung für Ihre Textanwendung gemeinsam zu bewerten.
Infrastruktur- und Serving-Verantwortliche
Sie lernen, Lastprofile, Hardwarekapazität und Aufgabenenergie mit klaren Messgrenzen zu vergleichen.
Technische Entscheider
Sie führen Messergebnisse, Zielkonflikte und Annahmen in einer nachvollziehbaren Architekturentscheidung zusammen.
Was Menschen mit diesem Buch tun
Beispiele aus dem Alltag der Leserinnen und Leser — mit der KI, die sie ohnehin nutzen.
Was am Ende auf dem Tisch liegt
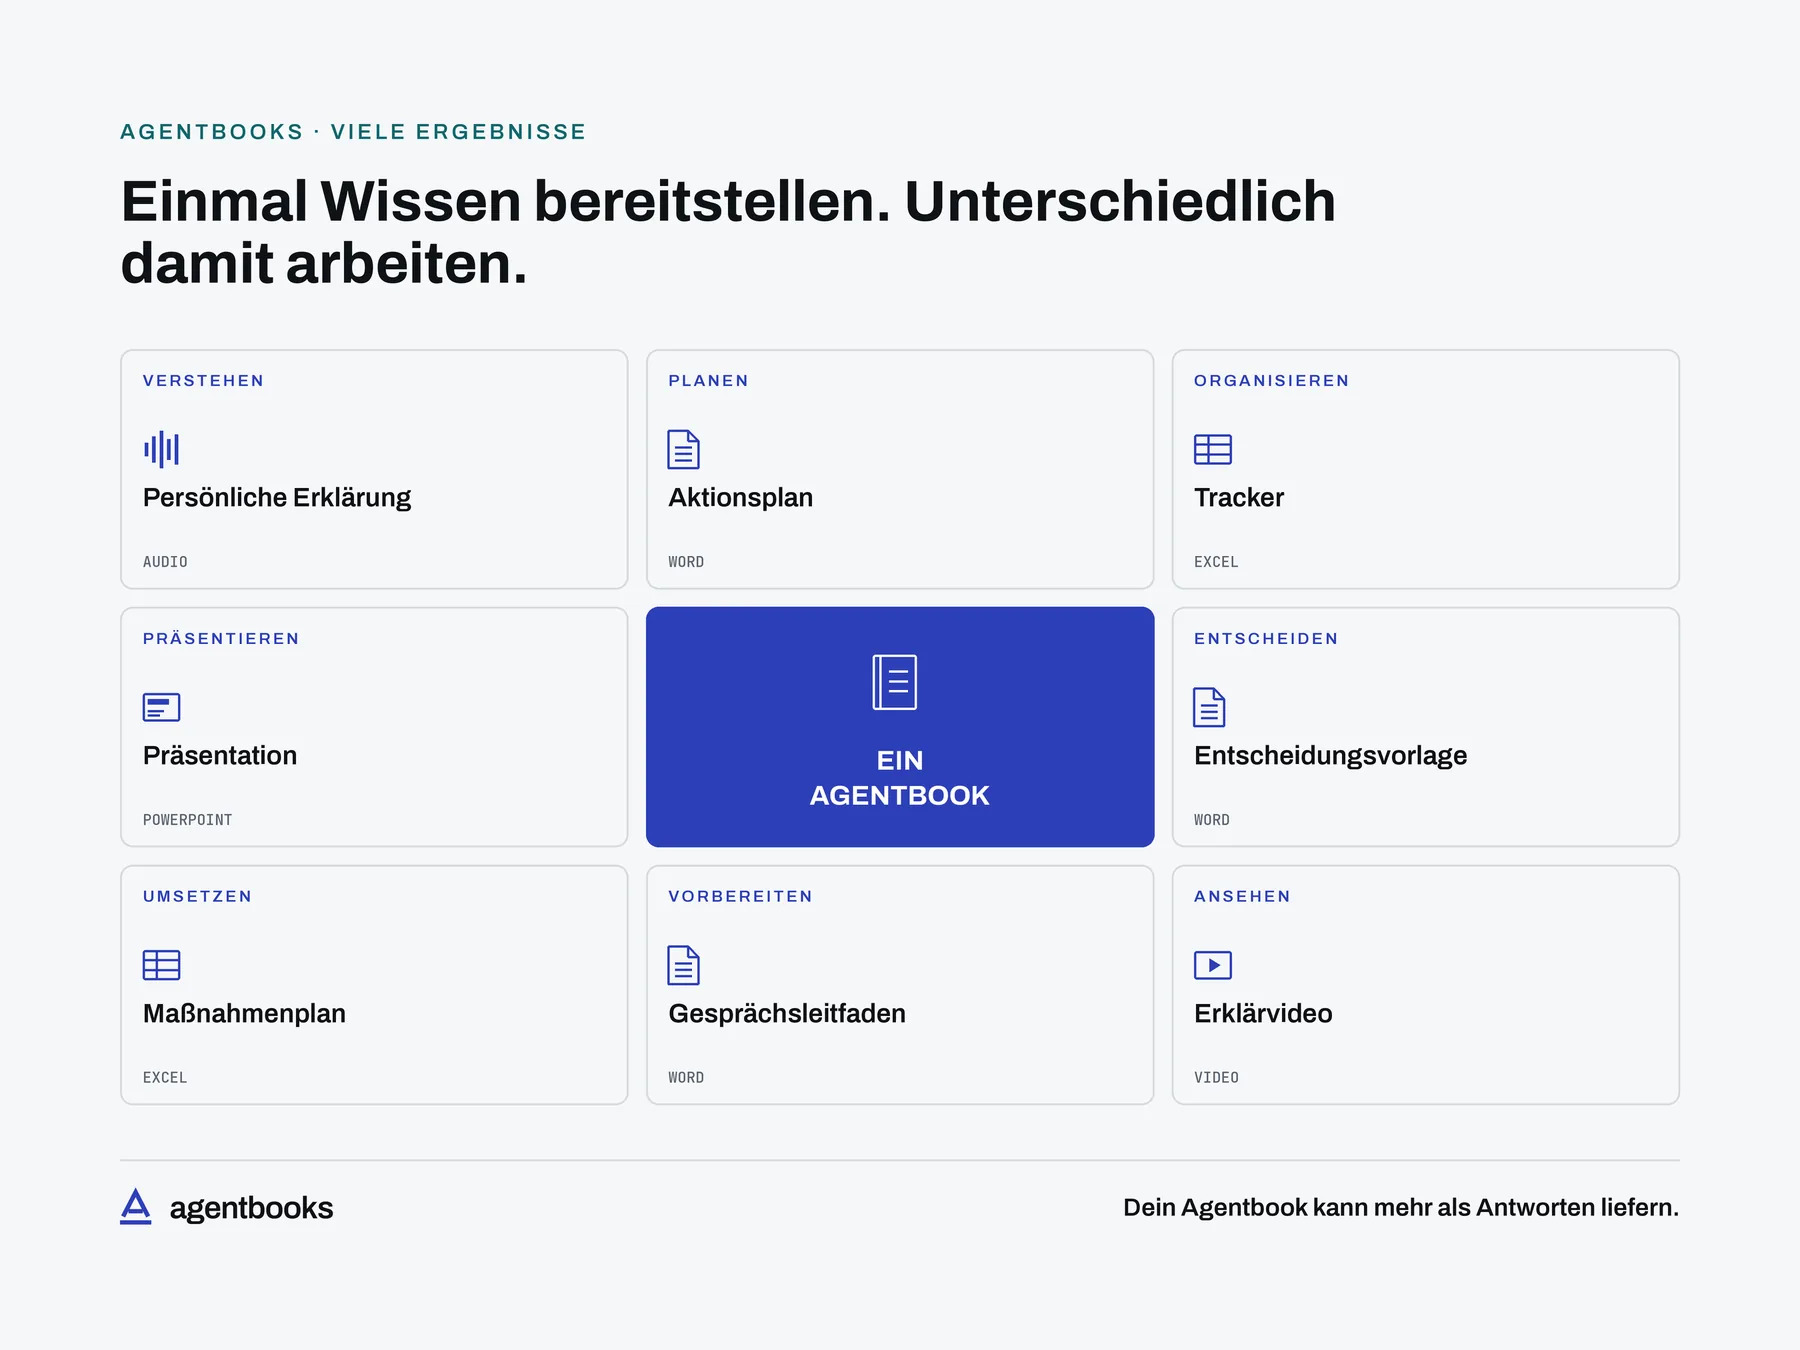
Konkrete Arbeitsergebnisse, die mit diesem AgentBook entstehen — mit Aufbau und Umfang, wie sie im Alltag gebraucht werden.
Was du danach kannst
Bevor du dich entscheidest
Welche Vorkenntnisse brauche ich?
Grundkenntnisse in Machine Learning, Softwarearchitektur und Statistik werden vorausgesetzt. Das Buch definiert zentrale Kennzahlen und arbeitet mit Formeln, Messprotokollen, Konfigurationsbeispielen und Fehleranalysen.
Empfiehlt das Buch ein bestimmtes Modell oder die schnellste Hardware?
Nein, es gibt keine pauschale Produktempfehlung. Sie lernen, Kandidaten anhand Ihrer Aufgaben, Qualitätsgrenzen und Lastbedingungen zu vergleichen und ihre jeweiligen Vorzüge nachvollziehbar abzuwägen.
Welche Arbeitsmittel bietet das Buch?
Zum Prüfprozess gehören eine Systemskizze, ein ausfüllbares Anforderungsblatt, ein Versuchsplan mit Messprotokoll, ein Bewertungsraster für Modellkandidaten, Versuchsmatrizen für Quantisierung und Routing, ein Serving-Konfigurations- und Testplan sowie ein Hardware-Messblatt. Eine Entscheidungsvorlage und ein Revalidierungsplan unterstützen die Auswahl und ihre spätere Überprüfung.
Kann ich damit eine bestimmte Einsparung erwarten?
Das Buch verspricht keine feste Einsparung oder Leistungssteigerung. Es zeigt, wie Sie Wirkungen unter kontrollierten Bedingungen prüfen und feststellen, welche Optionen Ihre Anforderungen erfüllen.
Wie weit reicht die Behandlung der Betriebskosten?
Der wirtschaftliche Schwerpunkt liegt auf der getrennten Zuordnung von Lizenzdauer, Supportumfang und Supportdauer. Ein Lizenz- und Supportvermerk hilft, diese Bedingungen für den Vergleich festzuhalten. Eine vollständige Betriebskostenrechnung liefert das Buch nicht.
Was behandelt das Buch nicht?
Modelltraining als eigenständiges Optimierungsfeld, Chipentwurf und allgemeine Rechenzentrumsplanung liegen außerhalb des Gegenstands. Ebenso liefert das Buch keine umfassenden Klimabilanzen und keine individuelle Rechts- oder Lizenzberatung.
Und das AgentBook kann noch mehr
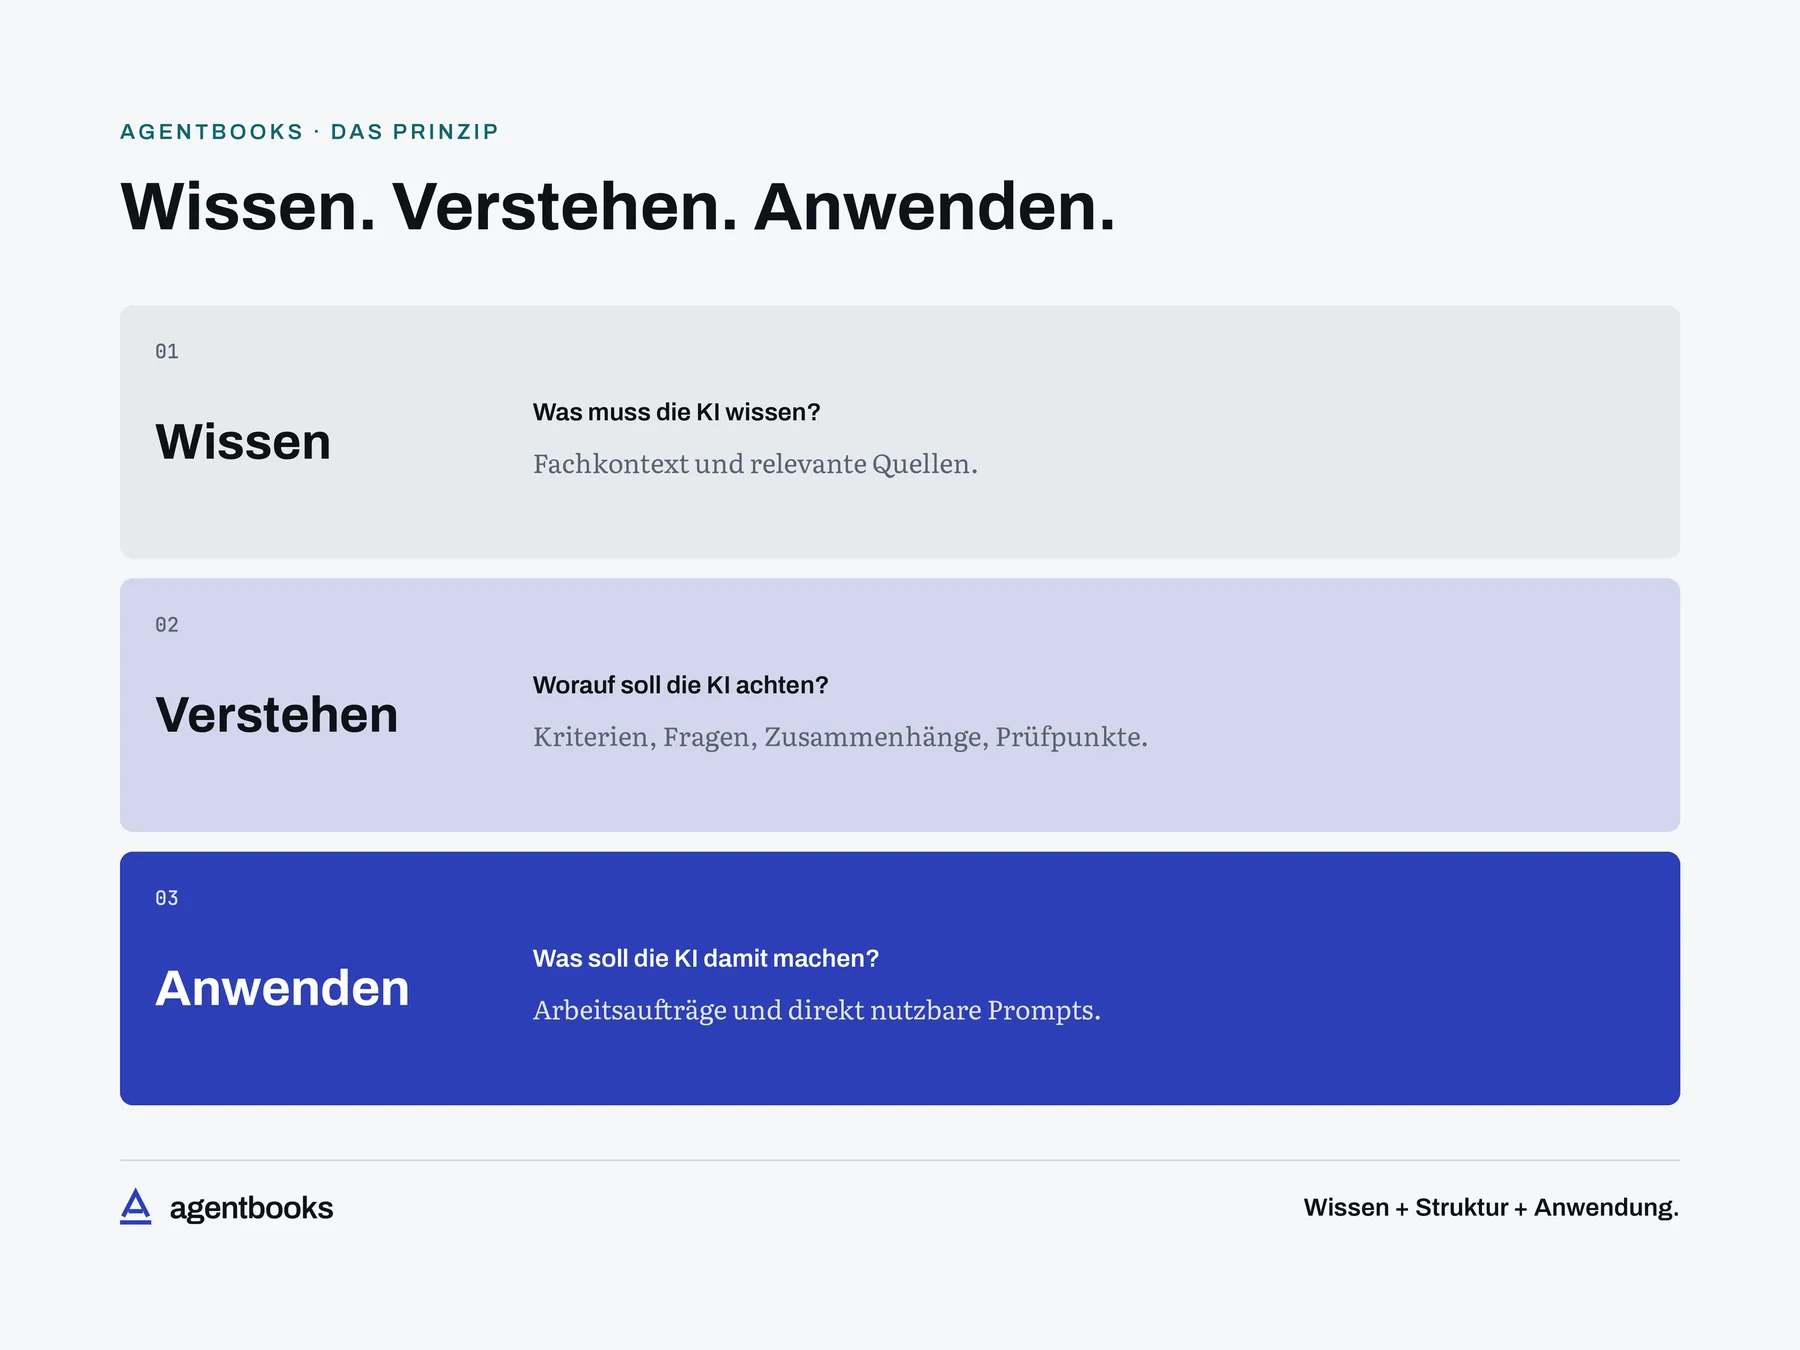
Sechs Bilder, die zeigen, was in einem AgentBook steckt: das Prinzip, der Unterschied zur KI allein, wie aus einer Frage ein Arbeitsergebnis wird — und warum die KI, die du schon nutzt, genau die richtige dafür ist.